Les sites e-commerce génèrent des milliers d’URL inutiles via leurs filtres et leur pagination. Ce phénomène s’apparente à une fuite d’eau invisible qui gaspille jusqu’à 99% de votre budget de crawl. Googlebot passe son temps à explorer des pages de tri par prix ou des combinaisons de couleurs sans fin plutôt que de découvrir vos nouveaux produits.
La gestion technique de ces éléments représente le défi majeur des boutiques en ligne. Facettes et pagination offrent une expérience utilisateur nécessaire mais créent une complexité technique redoutable pour les moteurs de recherche. Une stratégie mal calibrée dilue votre autorité et bloque la croissance organique.
En tant que consultant SEO et spécialisé dans les stratégies SEO e-commerce complexes, je transforme souvent cette faiblesse technique en levier de croissance. Une architecture saine permet de récupérer plus de 95% du trafic organique perdu. Ce guide constitue un framework décisionnel pour reprendre le contrôle de votre indexation.
Qu’est-ce que la navigation à facettes en e-commerce ?
La navigation à facettes permet aux utilisateurs d’affiner leur recherche produit grâce à des filtres précis : taille, couleur, marque, gamme de prix ou caractéristiques techniques. C’est le standard de l’UX en e-commerce pour aider l’internaute à trouver rapidement son produit dans un catalogue profond.
L’excellence de l’expérience utilisateur se transforme souvent en cauchemar pour le référencement naturel. Chaque filtre appliqué modifie l’URL, créant potentiellement une nouvelle page aux yeux de Google. Le problème réside dans l’explosion combinatoire. Prenons un exemple mathématique simple pour une catégorie contenant seulement 3 types de filtres :
Si vous autorisez la sélection multiple (ex: Bleu ET Rouge), le nombre de combinaisons grimpe de manière exponentielle vers des milliers d’URLs pour une seule catégorie. Une URL facettée typique ressemble à ceci : /chaussures-homme?couleur=noir&pointure=42&prix=50-100.
Les types de facettes courantes
- Filtres d’attributs produits (Matière, dimensions, puissance).
- Filtres de disponibilité (En stock, précommande).
- Filtres de tri (Prix croissant, nouveautés, avis clients).
- Filtres thématiques (Marque, collection, saison).
Le saviez-vous ? Le terme « facettes » vient de la science de l’information (classification à facettes de Ranganathan). Il désigne la capacité à classer un même objet selon plusieurs dimensions simultanées, contrairement à une hiérarchie arborescente unique.
Besoin d’un coup de boost SEO ?
Les 3 dangers SEO d’une mauvaise gestion des facettes
Laisser votre navigation à facettes en accès libre aux robots sans garde-fous expose votre site à trois risques majeurs qui plombent les performances.
Gaspillage du budget de crawl
Google alloue des ressources finies à chaque site. Si Googlebot passe 90% de son temps à crawler des pages générées par des filtres « Prix croissant » ou des combinaisons « Couleur + Taille + Matière » sans volume de recherche, il délaisse vos pages stratégiques. J’ai audité des sites où les nouvelles fiches produits mettaient trois semaines à s’indexer car le bot était perdu dans les méandres des filtres.
Index bloat et dilution d’autorité
L’index bloat survient lorsque Google indexe des milliers de pages de faible qualité ou quasi-identiques. Votre autorité globale (PageRank) se divise alors entre ces milliers d’URLs inutiles au lieu de se concentrer sur vos catégories principales. Imaginez verser une bouteille de vin de grand cru (votre autorité) dans 10 000 verres à shot plutôt que dans 50 belles carafes. Le résultat est une perte de puissance sur vos mots-clés concurrentiels.
Signaux contradictoires et confusion algorithmique
Une mauvaise implémentation technique envoie des signaux flous. Si une facette est accessible mais canonicalisée vers la catégorie mère tout en étant dans le sitemap, Google ne sait plus quelle version prioriser. Cette confusion ralentit le traitement algorithmique de votre site et diminue la confiance que le moteur lui accorde.
Métrique | Site sans stratégie (Chaos) | Site optimisé (Maîtrisé) |
|---|---|---|
Pages crawlées / jour | 50 000 (dont 49k inutiles) | 5 000 (100% utiles) |
Délai indexation nouveaux produits | 15 à 20 jours | Moins de 24h |
Qualité perçue (Panda/Quality score) | Faible (contenu dupliqué) | Élevée (pages uniques) |
Pagination en e-commerce : enjeux et opportunités SEO
La pagination permet de scinder les longues listes de produits. Son traitement technique influence directement la profondeur de crawl et l’accessibilité des fiches produits anciennes.
Les différents types de pagination
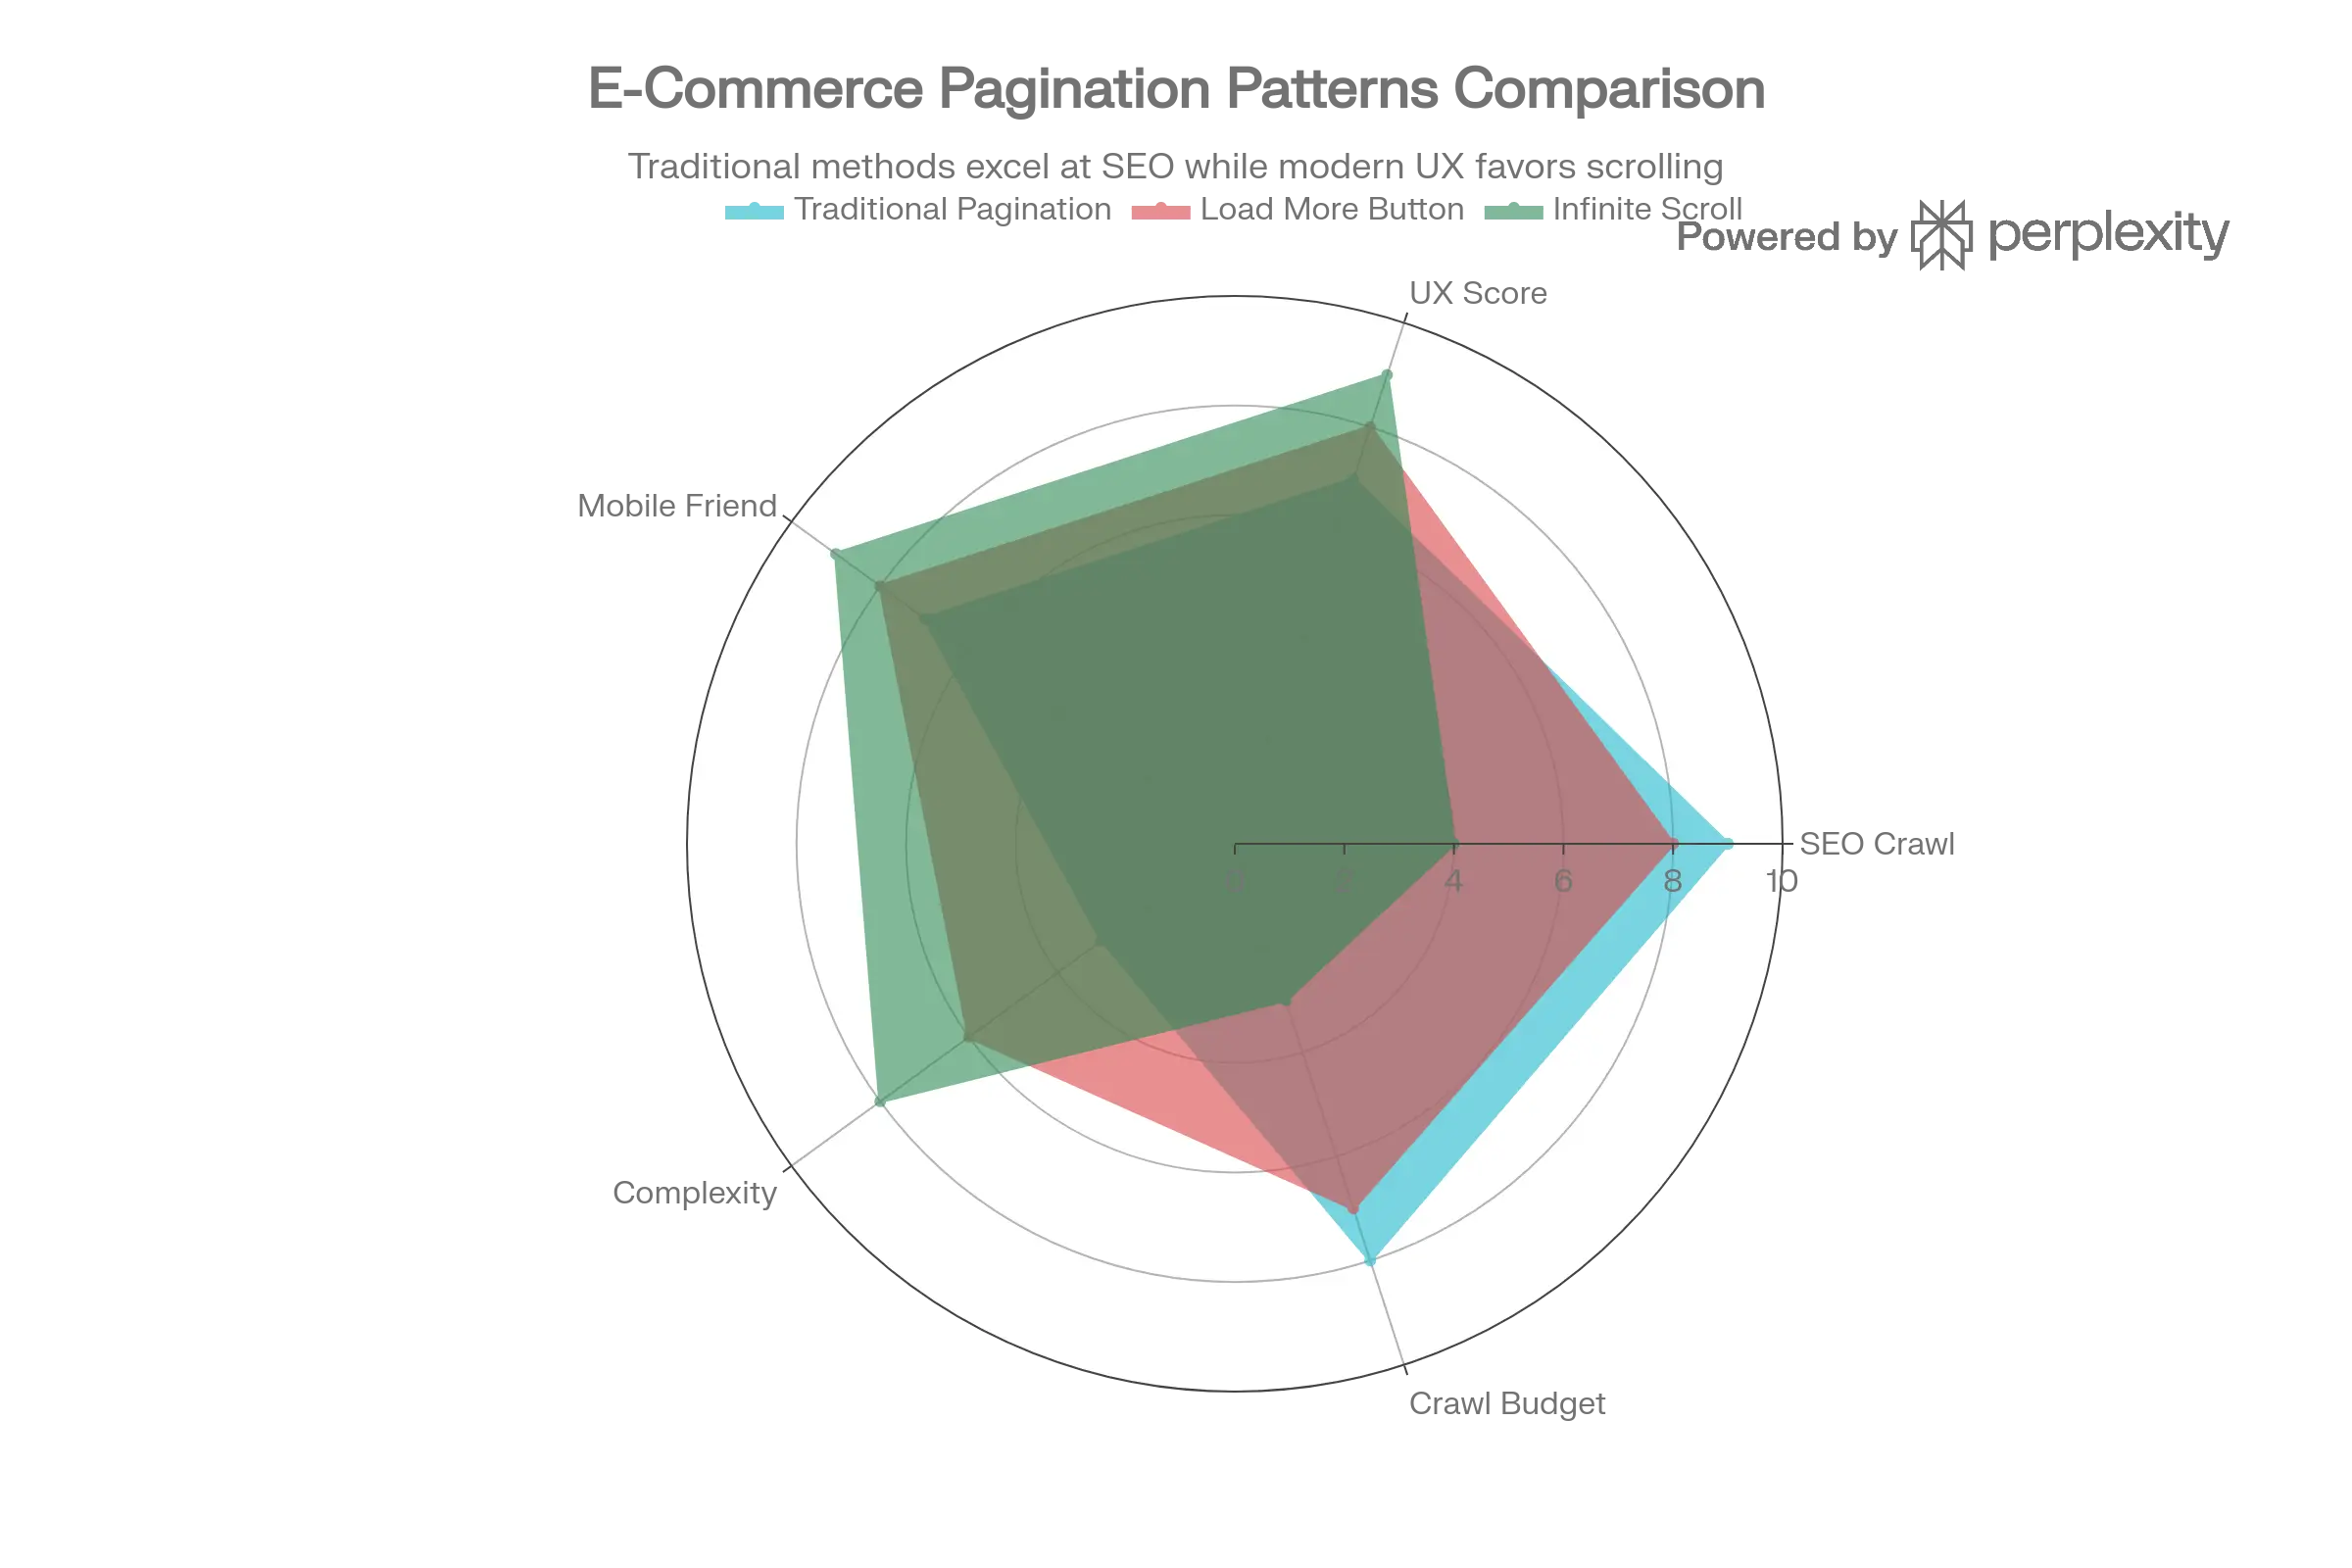
On distingue principalement la pagination numérotée classique, le bouton « Charger plus » (Load More), le défilement infini (Infinite Scroll) et la pagination concertina (saut de pages par dizaines). Chaque méthode possède ses implications pour la découverte des contenus.
Impact SEO de chaque méthode
Google reste capable de suivre des liens href classiques. Les solutions basées uniquement sur le JavaScript (comme un bouton Load More mal codé) peuvent rendre les produits des pages 2 et suivantes invisibles au bot.
Méthode | Score SEO | Score UX Mobile | Complexité technique |
|---|---|---|---|
Pagination numérotée | Excellent | Moyen | Faible |
Bouton « Load More » | Bon (si fallback) | Bon | Moyenne |
Infinite Scroll | Risqué | Excellent | Élevée |
Pagination Concertina | Très Bon | Moyen | Moyenne |
Robots.txt : la première ligne de défense contre le crawl inutile
Le fichier robots.txt représente la méthode la plus radicale et la plus efficace pour préserver votre budget. Il interdit purement et simplement l’accès à certaines zones du site. Googlebot ne charge pas la page, ne lit pas le code et passe son chemin.
Cette solution convient parfaitement aux facettes qui ne génèrent aucune valeur SEO (tris, filtres de prix dynamiques, combinaisons multiples). Attention : une page bloquée par le robots.txt ne transfère pas de jus de lien (PageRank).
User-agent: *

# Bloquer les tris

Disallow: /*?sort=*
Disallow: /*&sort=*

# Bloquer les filtres de prix

Disallow: /*?price=*
Disallow: /*&price=*

# Bloquer les combinaisons multiples (ex: 2 filtres et +)

Disallow: /*?*&
Paramètres à bloquer systématiquement
- Les tris (prix croissant/décroissant, alphabétique).
- Les limites d’affichage (10, 20, 50 produits par page).
- Les sessions IDs ou paramètres de tracking interne.
- Les vues alternatives (grille vs liste).
Envie d’un audit gratuit ?
Je vous offre un pré-audit SEO gratuit sous 48h. Vous saurez exactement comment votre site est vu par Google, quels points améliorer, et sur quels mots-clés vous pouvez vous positionner
Balises canonical : consolider l’autorité des pages similaires
La balise canonical indique à Google quelle version d’une page doit être considérée comme l’originale. Elle sert à consolider les signaux de classement (liens, comportement utilisateur) vers une URL maîtresse.
Pour des facettes de moyenne valeur (ex: filtre « Couleur » sur une page produit générique), la canonical vers la page catégorie parente permet d’éviter la duplication de contenu tout en laissant la page accessible aux utilisateurs. Mais attention : Googlebot doit tout de même crawler la page pour lire la balise, ce qui ne résout pas le problème du budget d’exploration.
Meta noindex : réduire l’index bloat de manière réversible
La balise meta noindex offre une flexibilité supérieure au robots.txt. Elle autorise Google à visiter la page mais lui interdit de l’ajouter à son index. C’est l’outil idéal pour nettoyer un site victime d’index bloat.
Contrairement au blocage pur, l’utilisation de noindex, follow permet de maintenir la circulation du jus de lien vers les produits listés sur la page, tout en gardant cette page hors des résultats de recherche. C’est une stratégie de transition efficace avant de passer au blocage par robots.txt une fois la désindexation constatée.
Comment prioriser vos facettes : le framework décisionnel
Vous ne devez pas traiter toutes les facettes de la même manière. La clé réside dans l’analyse de la valeur commerciale et sémantique. Voici mon framework de priorisation pour structurer votre approche.
Analyser la valeur commerciale de chaque facette
Utilisez la Search Console et vos outils de mots-clés pour identifier si des requêtes existent pour « Catégorie + Filtre ». Par exemple, « Canapé » + « Velours » possède un fort volume de recherche. À l’inverse, « Canapé » + « Prix 300-400€ » ne correspond à aucune requête utilisateur précise.
Classification en 4 catégories
Catégorie | Critères | Stratégie recommandée |
|---|---|---|
1. Haute Valeur | Vol. recherche élevé + Intention claire | Indexable + Canonical auto-référencée + URL propre |
2. Moyenne Valeur | Vol. recherche faible / Longue traîne | Indexable (sélectif) OU Canonical vers parent |
3. Faible Valeur | Utile UX mais zéro SEO (ex: tailles) | Noindex, Follow |
4. Sans Valeur | Tris, affichage, prix arbitraires | Blocage robots.txt immédiat |
Optimiser la pagination : les recommandations Google 2026
Google a clarifié sa position sur la pagination SEO. Les balises rel="next" et rel="prev" ne sont plus utilisées comme signaux d’indexation depuis plusieurs années, bien que certains CMS les conservent.
La règle d’or actuelle impose que chaque page paginée (page 2, page 3…) possède une URL unique, crawlable via un lien HTML standard (<a href>) et dispose d’une balise canonical auto-référencée. Une erreur fréquente consiste à canonicaliser la page 2 vers la page 1. Cela force Google à ignorer le contenu des pages suivantes, rendant orphelins tous les produits qui s’y trouvent.
<!-- Page 1 -->
<a href="/products?page=2">Next</a>

<!-- Page 2 -->
<a href="/products?page=1">First</a>
<a href="/products?page=3">Next</a>
<a href="/products?page=1">Previous</a>
Les règles d’or de la pagination
- Canonical auto-référencée sur chaque page de la séquence.
- Liens de pagination en HTML brut, pas de JS onclick.
- Ne pas mettre les pages paginées en noindex (sauf stratégie très spécifique).
- Optimiser les balises Title : « Catégorie – Page 2 ».
- Code 404 correct si l’utilisateur demande une page hors séquence (ex: page 999).
Téléchargez gratuitement votre guide SEO e‑commerce
Découvrez les méthodes clés pour optimiser votre boutique en ligne et attirer plus de clients grâce au référencement naturel.
Techniques avancées pour grands catalogues e-commerce
Pour les sites dépassant les 100 000 URL, des techniques plus fines s’imposent pour maîtriser la crawlability.
Fragments d’URL (#) pour éliminer la prolifération
L’utilisation de l’identifiant de fragment (le hashtag #) empêche le serveur de traiter la requête comme une nouvelle page. Googlebot ignore généralement ce qui suit le #. C’est une solution radicale pour gérer les facettes purement UX sans impact serveur ni SEO.
Normalisation des paramètres d’URL
L’ordre des paramètres ne doit pas générer de doublons. ?color=red&size=m et ?size=m&color=red sont deux URL différentes pour un moteur. Forcez la réécriture des URL parameters dans un ordre alphabétique strict côté serveur pour éviter cette duplication technique.
Données structurées schema.org
L’intégration des données structurées (ItemList) sur les pages de liste aide Google à comprendre la structure du catalogue. Le balisage BreadcrumbList est indispensable pour clarifier la hiérarchie parent-enfant générée par les facettes indexables.
Exemple de données structurées 👇
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "BreadcrumbList",
      "name": "Fil d'ariane",
      "description": "Indique la position de la facette indexée dans l'arborescence",
      "itemListElement": [
        {
          "@type": "ListItem",
          "position": 1,
          "name": "Accueil",
          "item": "https://www.monsite.com/"
        },
        {
          "@type": "ListItem",
          "position": 2,
          "name": "Chaussures",
          "item": "https://www.monsite.com/chaussures/"
        },
        {
          "@type": "ListItem",
          "position": 3,
          "name": "Chaussures en Cuir",
          "item": "https://www.monsite.com/chaussures/cuir"
        }
      ]
    },
    {
      "@type": "ItemList",
      "name": "Liste des produits",
      "description": "Liste ordonnée des produits affichés sur cette page de pagination/facette",
      "numberOfItems": 24,
      "itemListElement": [
        {
          "@type": "ListItem",
          "position": 1,
          "url": "https://www.monsite.com/produit-a-cuir.html"
        },
        {
          "@type": "ListItem",
          "position": 2,
          "url": "https://www.monsite.com/produit-b-cuir.html"
        },
        {
          "@type": "ListItem",
          "position": 3,
          "url": "https://www.monsite.com/produit-c-cuir.html"
        }
        // ... continuer pour tous les produits de la page
      ]
    }
  ]
}
</script>
Infinite scroll et JavaScript : comment rester SEO-friendly
L’infinite scroll séduit sur mobile, mais le Googlebot ne « scrolle » pas. Sans intervention, il ne voit que les premiers produits chargés.
La solution robuste consiste à implémenter un « fallback » en pagination HTML classique. Lorsque le bot (ou un utilisateur sans JS) visite la page, il voit des liens de pagination standards « 1, 2, 3… ». Pour l’utilisateur humain avec JS actif, ces liens sont remplacés par le mécanisme de chargement infini. L’utilisation de l’History API permet de mettre à jour l’URL dans la barre d’adresse au fur et à mesure du défilement, permettant le partage de liens précis.
Monitoring et KPIs : mesurer l’efficacité de votre stratégie
Une stratégie d’indexation ne se lance pas à l’aveugle. Le pilotage se fait via des indicateurs précis.
Google Search Console
Surveillez le rapport « Pages ». La courbe des « Explorées, non indexées » doit baisser. Une augmentation soudaine signale souvent une fuite de crawl dans de nouvelles combinaisons de facettes.
Analyse des logs serveur
Les logs vous disent la vérité sur le comportement du bot. Identifiez les « spider traps » : ces boucles infinies où le bot visite des milliers d’URL de filtres sans jamais s’arrêter.
Checklist de monitoring mensuel
- Vérification du ratio pages indexées / pages soumises.
- Analyse des logs : top 10 des pages les plus crawlées (sont-elles stratégiques ?).
- Audit des chaînes de redirection sur les facettes.
- Contrôle de la prise en compte du
robots.txt.
Besoin d’un coup de boost SEO ?
Plan d’action sur 90 jours pour optimiser facettes et pagination
Mois 1 : Audit et diagnostic
Lancez un crawl complet avec un outil comme Screaming Frog ou Botify. Configurez-le pour ignorer le robots.txt afin de voir ce que vous bloquez réellement. Croisez ces données avec vos logs serveur et vos données Analytics. L’objectif est de cartographier chaque type de facette et son statut actuel.
Mois 2 : Implémentation blocage et dépriorisation
Appliquez les balises noindex sur les facettes « Faible valeur ». Modifiez le robots.txt pour les patterns « Sans valeur » (tris, limites). Assurez-vous que les canonicals pointent correctement. C’est la phase de nettoyage technique.
Mois 3 : Optimisation des pages stratégiques
Ouvrez l’indexation pour les facettes « Haute valeur ». Créez des règles de réécriture d’URL pour transformer ?cat=12&color=red en /canapes-rouges/. Enrichissez ces nouvelles pages avec du contenu unique et du maillage interne.
Les 7 erreurs fatales à éviter absolument
- Canonicaliser la pagination vers la page 1 : Vous tuez l’indexation de tout votre catalogue profond.
- Confondre noindex et robots.txt : Bloquer une page (
robots.txt) empêche Google de voir lenoindexqu’elle contient. - Infinite scroll sans liens href : Votre site devient une impasse pour les robots.
- Bloquer les fichiers CSS/JS : Google doit pouvoir « voir » la page comme un utilisateur pour valider l’UX.
- Signaux incohérents : Mettre une page dans le sitemap XML tout en la mettant en
noindex. - Oublier le maillage interne : Une facette indexable doit être liée depuis le contenu (pas juste le menu latéral).
- Négliger le mobile : Les filtres sont souvent gérés différemment sur mobile, vérifiez la parité des liens.
Conseil d’expert : Ne changez jamais tout d’un coup. L’indexation est une mécanique sensible. Procédez par section de site ou par type de filtre pour isoler les effets de bord.
Synthèse : votre stratégie optimale facettes + pagination
La performance SEO de votre e-commerce repose sur un triptyque : priorisation, consolidation technique et monitoring. Ne laissez pas la technique dicter votre visibilité. Prenez le contrôle en dictant aux robots exactement où aller via un usage intelligent du robots.txt et des règles d’indexation.
Une architecture maîtrisée transforme votre catalogue en une machine de guerre SEO, capable de positionner des milliers de requêtes longue traîne sans diluer la puissance de vos top catégories. L’investissement technique initial est vite rentabilisé par l’économie de ressources serveur et l’acquisition de trafic qualifié.
Quick Win : 3 actions pour cette semaine
- Vérifier que les pages 2+ de la pagination ont une canonical auto-référencée.
- Ajouter
Disallow: /*?sort=dans le robots.txt (après vérification). - Identifier 5 facettes à fort potentiel de trafic actuellement non indexées.
Envie d’un audit gratuit ?
Je vous offre un pré-audit SEO gratuit sous 48h. Vous saurez exactement comment votre site est vu par Google, quels points améliorer, et sur quels mots-clés vous pouvez vous positionner